Databricks
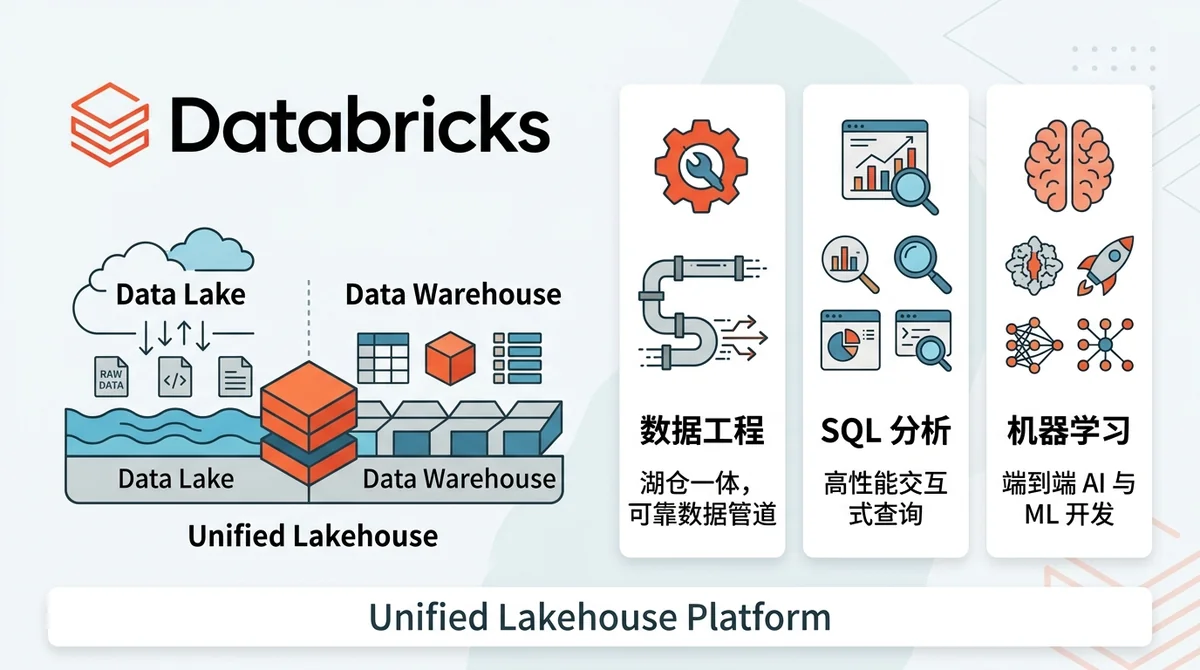
Databricks 是什么、核心能力覆盖哪些环节、五维打分如何、优缺点与适用团队边界。基于公开资料定性整理,含选型核对清单与 FAQ,未核实数据已标注。
结论:Databricks 是一个把数据工程、分析与机器学习工作流整合到同一平台的湖仓一体产品。按平台能力、易用性、生态集成、成本透明度、支持服务五维评估,其在平台能力与生态集成上相对突出,易用性与成本透明度是相对短板,更适合已有数据工程能力、需要湖仓与 ML 协同的中大型团队。本文评分为基于公开资料与产品定位的编辑判断(观点),非第三方基准测试结果。
#Databricks 是什么,它在数据栈里解决什么问题?
Databricks 是一个把数据工程、分析与机器学习工作流整合到同一平台的湖仓一体产品,主要解决数据在多系统间重复搬运与协作割裂的问题。
平台定位:数据工程、分析、机器学习的统一载体。它不是单点工具,而是把原本分散在数据仓库、ETL 工具、笔记本环境与 ML 平台的工作收敛到一处。
#它和传统数据仓库的定位差异在哪?
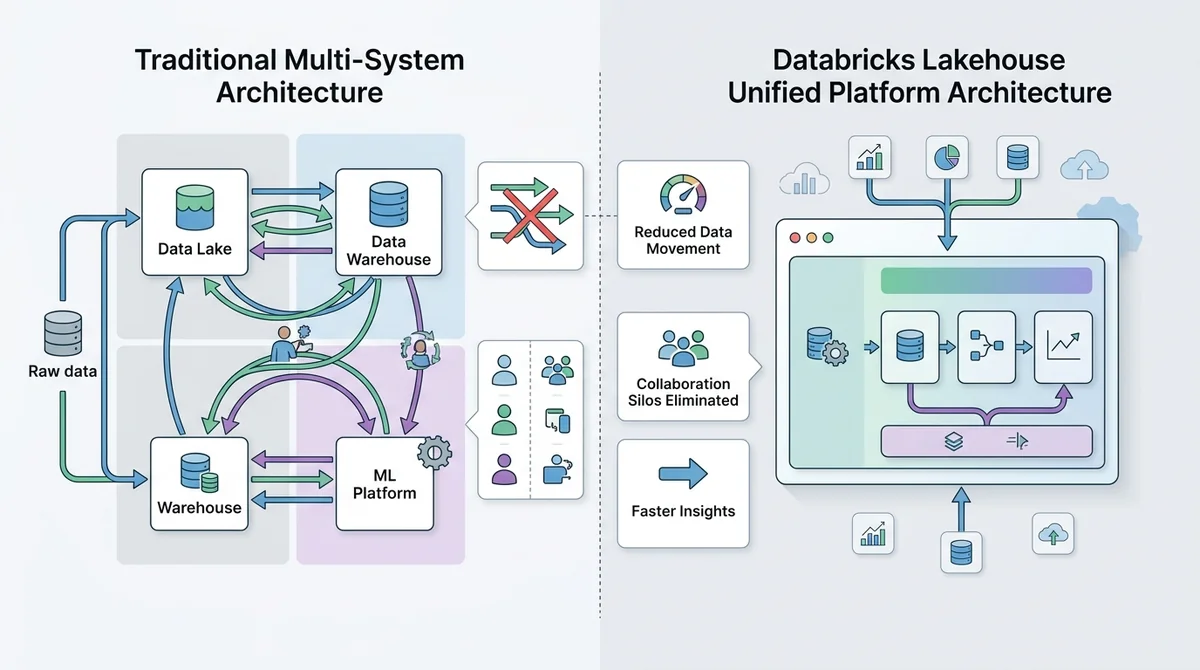
传统数据仓库的核心是结构化数据的存储与 SQL 查询,定位偏“分析末端”。Databricks 的定位更靠前,覆盖从数据接入、加工、分析到模型训练与部署的链路。差异不在单点功能强弱,而在环节之间的衔接方式:数据不必在多套系统间反复导出导入。
#湖仓一体架构能带来哪些实际收益?
湖仓一体的直接收益是减少数据在多套系统间反复搬运,降低同一份数据在仓库与数据湖之间出现口径不一致的概率。对同时有 BI 分析需求与机器学习需求的团队,这种统一载体的价值主要体现在协作效率与链路维护成本上,而非某一项查询性能的绝对领先。需要说明的是,这类收益属于机制层面的推断,实际幅度取决于团队原有的系统割裂程度与工程能力,缺乏公开的量化基准。
#哪些团队会把它作为核心数据平台?
有中等以上数据规模、且具备数据工程能力的团队更可能把它作为核心平台。判断依据是:是否有持续的数据管道维护需求、是否有 ML 工作流需要与分析链路共享同一份数据。若只是轻量报表需求,统一平台带来的复杂度可能超过收益。
#Databricks 的核心能力覆盖哪些环节?
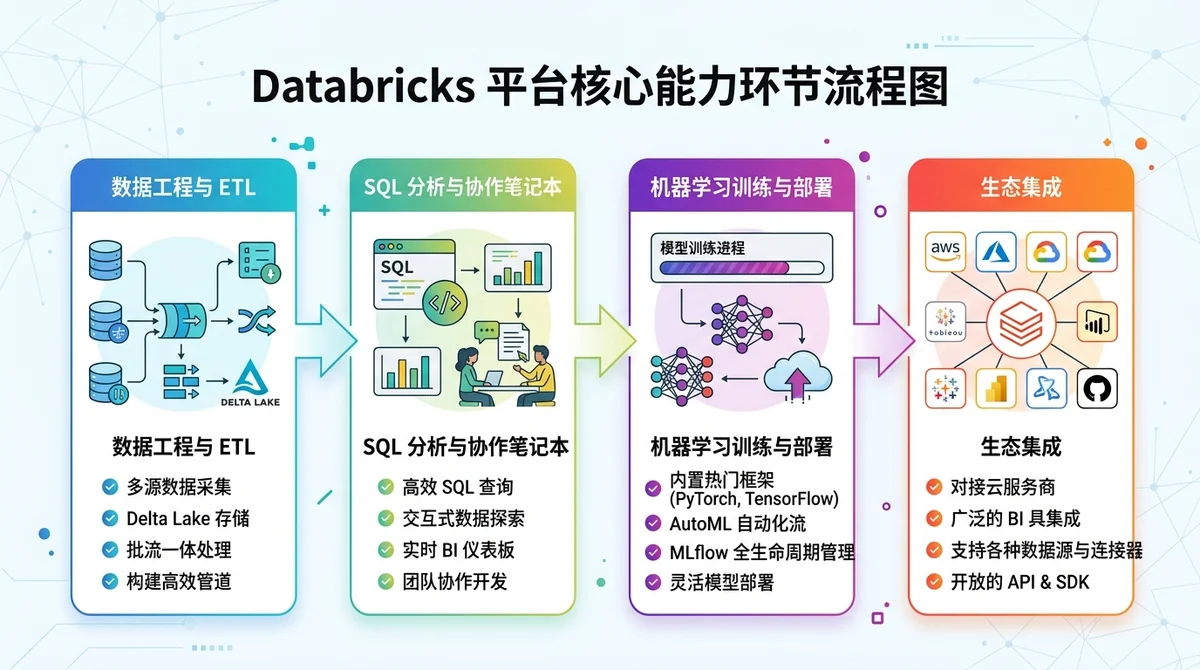
Databricks 的能力覆盖数据工程、SQL 分析、机器学习与生态集成四个环节,优势在于环节之间的衔接而非单点功能极致。
#数据工程与 ETL 能力如何?
数据工程侧以批流一体的处理能力为核心,适合需要同时处理离线批任务与流式数据的场景。具体吞吐、延迟等性能指标数据未公开,需以官方文档与自身压测为准。
#分析与 SQL 查询体验怎样?
分析层提供 SQL 与协作式笔记本两种入口,适合分析师与工程师在同一工作空间协作。查询性能与并发上限数据未公开,实际体验取决于集群配置与数据组织方式。
#机器学习和 AI 工作流支持到什么程度?
ML/AI 侧覆盖训练、实验与部署的衔接,价值在于模型训练所用的数据与分析所用的数据处于同一平台,减少特征口径不一致与数据搬运成本。具体支持的框架与部署形态数据未公开,以官方为准。
#生态集成和可扩展性如何?
生态侧与主流云与开源组件集成,这是其相对优势环节。可扩展性体现在按需接入外部工具而非全部自建,但集成深度与具体组件清单数据未公开,选型时需逐项核对。
#Databricks 五维打分:各项表现如何?
按平台能力、易用性、生态集成、成本透明度与支持服务五个维度评估,Databricks 在平台能力与生态集成上相对突出,易用性与成本透明度是相对短板。评分依据为公开资料与产品定位,属于编辑判断(观点),缺失数据标注为数据未公开,不做事后推测。
#平台能力与功能完整度打几分?
平台能力维度相对得分较高,依据是覆盖数据工程、SQL 分析、ML 与生态集成四个环节且环节之间衔接完整。单点功能是否行业最强缺乏可核实的横向基准,故不给满分。
#易用性与学习曲线怎么评价?
易用性维度相对得分中等偏下。湖仓一体涉及数据工程、集群配置与权限管理等多层概念,对无工程背景的团队学习曲线较陡。具体上手时长数据未公开。
#生态集成与扩展性打几分?
生态集成维度相对得分较高,依据是与主流云与开源组件的集成定位。具体集成数量、认证清单数据未公开,选型时应以自身工具链逐项核对。
#成本透明度与支持服务如何?
成本透明度维度相对得分偏低。成本随用量变化,缺乏固定报价结构,需自建监控与配额机制。支持服务的响应分级与 SLA 数据未公开,以官方为准。
#Databricks 的优缺点分别是什么?
Databricks 的主要优势是统一平台与生态集成,主要代价是学习曲线较陡和成本管理需要额外投入。
#主要优势集中在哪些方面?
统一平台:数据工程、分析与 ML 在同一载体,减少跨系统搬运与口径不一致。 生态集成:与主流云与开源组件集成,降低自建拼接成本。 ML 协同:训练与实验可直接复用分析链路的数据,缩短从分析到建模的路径。
#常见的限制和代价是什么?
学习曲线:涉及多层概念与配置,团队需要具备数据工程能力。 成本管理复杂度:成本随用量变化,缺乏固定报价结构,需额外建立监控与配额。 对工程能力有要求:平台价值高度依赖团队自身水平,能力不足时统一平台反而增加维护负担。
#谁适合用 Databricks,谁应该考虑其他方案?
已有数据工程能力、需要湖仓与机器学习协同的团队更适合 Databricks;轻量分析需求或人力预算有限的小团队应先评估替代方案。
#什么规模和类型的团队最适合?
有中等以上数据规模、需要同时维护数据管道与 ML 工作流的团队。典型特征是已有专职数据工程角色,且分析需求与建模需求共享同一批数据源。
#哪些场景下它并不划算?
轻量报表与临时分析场景,统一平台的配置与维护成本可能超过收益。人力预算有限、无专职数据工程角色的小团队,采用后可能长期停留在基础功能层。
#采用前应该先验证哪些问题?
先验证成本模型与现有工具链兼容性两项。成本模型决定长期可持续性,工具链兼容性决定迁移代价。两项均需以自身数据实测,公开数据不足以替代。
#使用 Databricks 需要注意哪些风险与限制?
使用 Databricks 的主要风险是成本随用量增长而失控,以及平台价值高度依赖团队自身的数据工程能力。
#成本管理上有哪些常见坑?
成本随用量变化,若无监控与配额机制,集群长时间运行或任务重复调度会带来不可预期的支出。建议在接入初期即建立用量看板与预算告警。具体价格与配额数据未公开,以官方为准。
#对团队能力有哪些隐性要求?
平台能力依赖团队工程水平。湖仓一体的收益来自环节衔接,而衔接需要有人维护管道、管理权限与优化任务。缺乏专职角色时,统一平台可能退化为仅用笔记本的轻量工具。
#FAQ
Q1:Databricks 和传统数据仓库的核心差别是什么? A:传统数据仓库定位偏分析末端,核心是结构化数据存储与 SQL 查询;Databricks 覆盖数据工程、分析、ML 与生态集成的完整链路,差别在环节衔接而非单点功能。
Q2:小团队适合用 Databricks 吗? A:轻量分析需求或人力预算有限的小团队应先评估替代方案。统一平台的配置与维护成本需要专职数据工程角色消化,否则可能长期停留在基础功能层。
Q3:Databricks 的成本结构透明吗? A:成本透明度是相对短板。成本随用量变化,缺乏固定报价结构,需自建监控与配额机制。具体价格数据未公开,以官方为准。
Q4:Databricks 的机器学习能力体现在哪? A:体现在训练、实验与部署的衔接,模型训练可直接复用分析链路的数据,减少特征口径不一致与数据搬运。具体支持的框架与部署形态数据未公开。
Q5:采用前最应该先验证什么? A:先验证成本模型与现有工具链兼容性。成本模型决定长期可持续性,工具链兼容性决定迁移代价,两项都需以自身数据实测。
本内容基于公开资料定性整理,属于编辑判断,不构成投资或采购建议。文中未引用具体价格、性能或 SLA 数字,相关数据请以 Databricks 官方来源为准。
常见问题
Databricks 和传统数据仓库的核心差别是什么?
传统数据仓库定位偏分析末端,核心是结构化数据存储与 SQL 查询;Databricks 覆盖数据工程、分析、ML 与生态集成的完整链路,差别在环节衔接而非单点功能。
小团队适合用 Databricks 吗?
轻量分析需求或人力预算有限的小团队应先评估替代方案。统一平台的配置与维护成本需要专职数据工程角色消化,否则可能长期停留在基础功能层。
Databricks 的成本结构透明吗?
成本透明度是相对短板。成本随用量变化,缺乏固定报价结构,需自建监控与配额机制。具体价格数据未公开,以官方为准。
Databricks 的机器学习能力体现在哪?
体现在训练、实验与部署的衔接,模型训练可直接复用分析链路的数据,减少特征口径不一致与数据搬运。具体支持的框架与部署形态数据未公开。
采用前最应该先验证什么?
先验证成本模型与现有工具链兼容性。成本模型决定长期可持续性,工具链兼容性决定迁移代价,两项都需以自身数据实测。