NVDA vs AMD AI:2026 架构、软件生态与 TCO 全方位对比
深度对比 NVDA 与 AMD AI 架构、CUDA 与 ROCm 生态及部署 TCO,为 2026 硬件投资与资产配置提供决策参考。
#NVDA vs AMD AI:2026 架构、软件生态与 TCO 全方位对比
NVIDIA (NVDA) 靠着 CUDA 专有生态和 NVLink 高速互连,长期吃下企业级 AI 的大部分蛋糕。另一边,AMD 带着 Instinct 系列加速器发起猛攻,用更具竞争力的显存容量和开源 ROCm 平台,给那些想摆脱单一供应商绑定的企业提供了一个高性价比方案。
#核心要点
- 架构路线:NVIDIA 坚持软硬件深度绑定的垂直计算互连架构;AMD 则主打单卡内封装更大的显存密度与模块化设计。
- 软件护城河:CUDA 积累了十余年的开发者生态与网络效应;AMD ROCm 近年来快速迭代,正在抹平 PyTorch 等主流框架中的体验差距。
- 总体拥有成本 (TCO):AMD 拿出了更有吸引力的单算力性价比与供货周期,正面制衡 NVIDIA 的高溢价与成熟生态。
- 资产配置逻辑:配置 NVDA 还是 AMD,本质是在行业龙头的确定性、高利润壁垒,与挑战者的成长弹性、开源红利之间做权衡。
#NVIDIA 与 AMD 的 AI 芯片架构有何差异?
在数据中心 AI 加速领域,两家厂商的工程思路大不相同:NVIDIA 走的是统合型单片设计(Monolithic),AMD 则深耕模块化小芯片(Chiplet)路线。
#硬件计算特性与理论吞吐量
NVIDIA 的主力数据中心 GPU 深度依赖专有 Tensor Core,对 FP8、FP4 等低精度浮点运算做了深度调优,旨在把大语言模型(LLM)的训练和实时推理吞吐拉到极限。AMD 的 Instinct 系列基于 CDNA 架构,采用 Chiplet 模块化设计,在先进制程上能维持更好的良率与扩展灵活性。如果你想了解更广泛的芯片竞争格局,参考 Nvidia vs AMD vs Broadcom 可以更直观地看清不同硬件路径的市场定位。
#内存带宽、高带宽内存 (HBM) 与互连技术
超大规模集群能跑多快,很大程度上看互连带宽与板载显存:
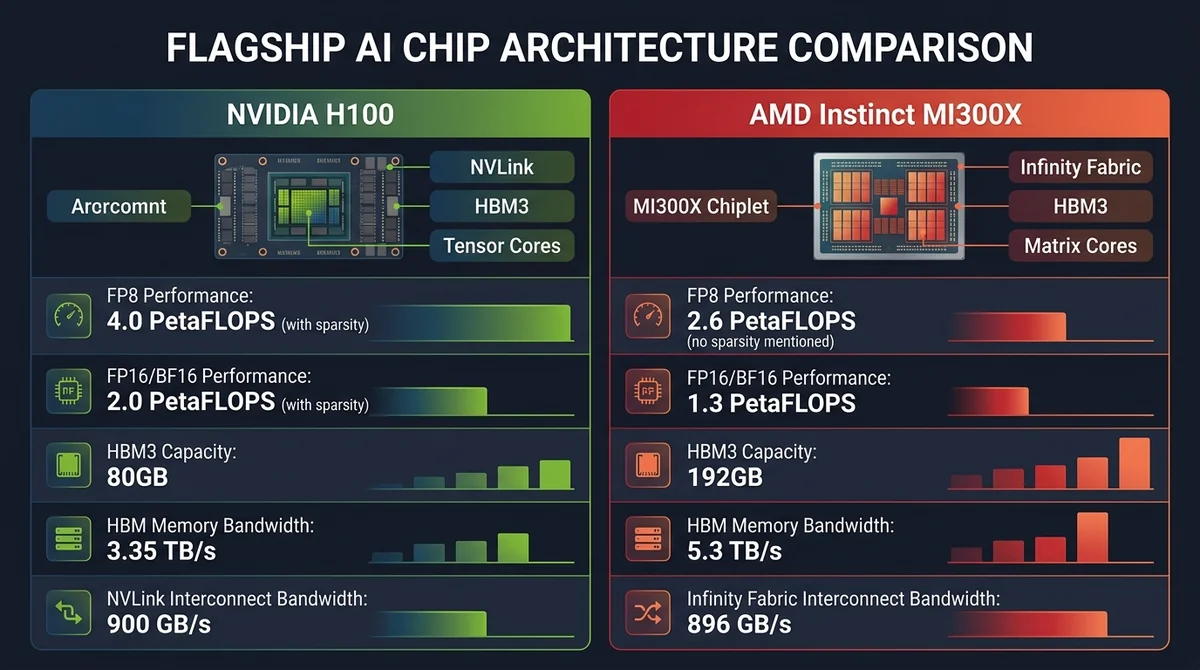
- 互连方案:NVIDIA 依靠自研的 NVLink,在集群内部搭建超高速、低延迟的 GPU 直连通道;AMD 则使用 Infinity Fabric,打通机架内部 CPU 到 GPU、GPU 到 GPU 的异构通信。
- HBM 容量策略:AMD 的打法是在单卡封装中堆叠更大的 HBM 显存容量,让大参数模型跑在更少的卡上;NVIDIA 则更侧重利用专有缓存层级来压榨显存带宽的实际利用率。
| 规格维度 | NVIDIA 旗舰数据中心架构 | AMD Instinct 加速器架构 |
|---|---|---|
| 架构风格 | 纵向整合的计算互连架构 | 模块化小芯片 (CDNA) 架构 |
| 互连标准 | NVLink(专有超密网格) | Infinity Fabric(异构互连) |
| 内存策略 | 均衡密度与深度缓存层级 | 单加速器原生 HBM 容量最大化 |
| 核心优化目标 | 端到端多节点扩展能力 | 单节点内存容量与计算密度 |
#CUDA 与 ROCm 软件生态系统的核心区别是什么?
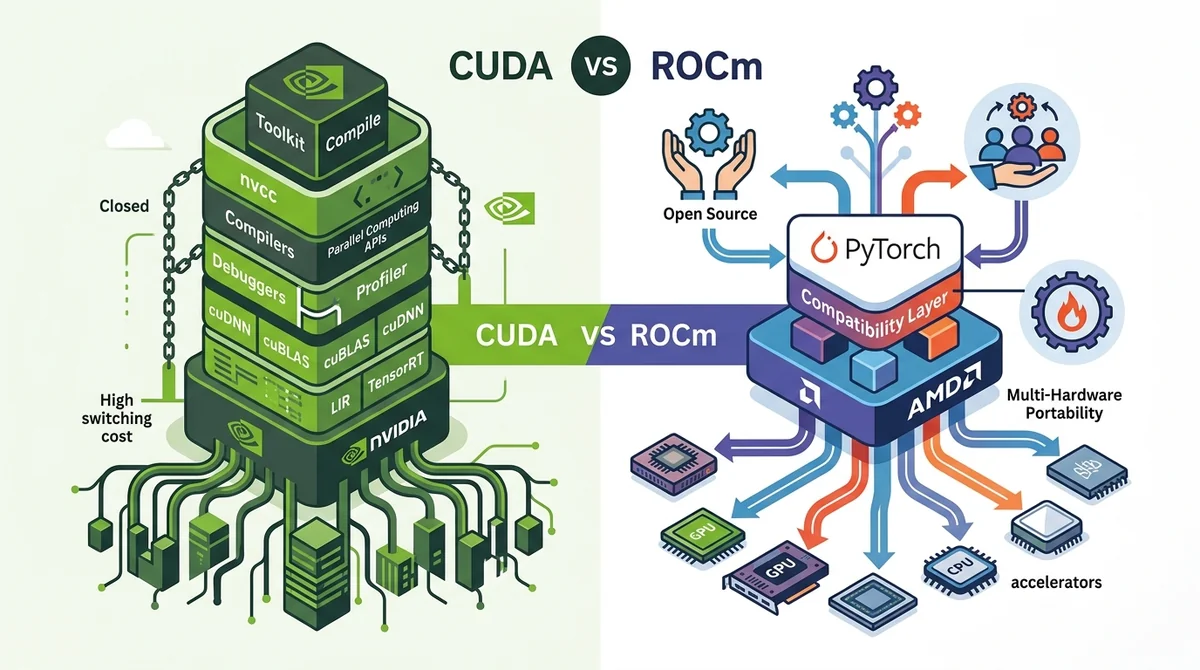
硬件决定上限,软件生态才决定实际落地的产出效率与迁移门槛。
#开发者工具链与框架原生支持
NVIDIA 凭借 CUDA 构筑了极深的软件护城河,开箱即用。十多年来,绝大多数 AI 顶会论文和工业界代码库都是以 CUDA 为底座写的,新模型发布往往具备零日兼容性(Day-one Compatibility)。AMD 的 ROCm 正在通过与 PyTorch 基金会及主流开源社区的深度绑定快速赶超,现在跑绝大多数标准训练和推理脚本,已经基本不需要手动重写底层算子(Kernel)。
#专有优化与开源可移植性
选择 CUDA 还是 ROCm,就是在省心与自由之间权衡:
- CUDA 生态系统:cuDNN、TensorRT、NCCL 等底层库打磨得极为成熟,不需要花太多精力就能把硬件算力榨干。
- ROCm 生态系统:走开源可移植路线,超大规模云厂商和企业能自由修改编译器底层,避免被单一硬件厂商锁死。
- 迁移开销:虽然 HIP 等代码转换工具能把 CUDA 代码转过去,但老旧架构和复杂流水线在迁移时,依然需要预留不少工程调试与适配工时。
#NVDA 与 AMD 在企业部署成本与可用性上有何不同?
企业在采购 AI 算力时,必须在前期昂贵的硬件资本支出与长期运营效率之间找到平衡点。
#硬件采购与供货周期
NVIDIA 依靠统领级地位握有绝对定价权,硬件溢价高,供求紧张时提货周期较长。AMD 则将 Instinct 定位为高性价比、供给更有保障的备选方案,靠着更具诚意的供货条款吸引超大规模云厂商和二线云基础设施供应商。关注二级市场估值差异的投资者,常会研究 NVDA 类似标的股票 或对比 AMD 股价能否赶超英伟达 来衡量两者定价权的强弱。
#总体拥有成本 (TCO) 与能效比
看算力账本不能只看首发采购价,全生命周期的 TCO 才是关键:
- 单次推理功耗:NVIDIA 芯片配合自研网络方案,在大规模数据中心集群中能跑出极高的每瓦性能比。
- 单节点算力密度:AMD 单卡显存更大,跑某些超大模型时可以减少所需的物理服务器节点,直接节省机柜空间、供电和散热支出。
- 工程人力成本:工程师普遍熟悉 CUDA,上手快;采用 ROCm 则通常需要配备专门的底层工程团队做针对性性能调优。
#NVDA vs AMD AI:哪种战略画像契合您的投资框架?
在 AI 赛道配置 NVDA 或 AMD,是在行业霸主的确定性盈利与追赶者的市场份额弹性之间做取舍。NVIDIA 像一台全速运转的盈利机器,毛利率极高,有端到端的软硬件网络全栈闭环;AMD 则以务实的挑战者姿态,靠解决显存痛点和性价比策略,为预算收紧的数据中心提供第二选择。
#市场龙头与定价权 vs 市场份额扩张空间
两家公司的商业画像非常鲜明:
- NVIDIA 画像:适合看重定价权、强软件网络效应和成熟云端整合能力的投资逻辑。想通过代币化股票参与这类资产配置的投资者,可以查阅 NVIDIA 代币化股票交易平台榜单 了解交易渠道。
- AMD 画像:适合看好非对称市场份额增长、开源生态替代潮,以及云厂商多供应商分散化战略的投资者。
#竞争格局下的执行风险
两家巨头各有挑战。NVIDIA 需要面对开源编译框架的成熟,以及各大云厂商自研 ASIC 芯片的长期分流;AMD 则需要证明 ROCm 在复杂工业场景中的长期稳定性,同时拿到足够的先进封装产能,确保多节点集群在超大规模放量时表现一致。
#免责声明
本文仅供信息参考与交流,不构成财务、投资或采购决策建议。半导体硬件参数、软件兼容性与市场供应受多重动态因素影响。在做出任何投资或采购规划前,请务必进行独立的尽职调查。
常见问题
NVDA 与 AMD 的 AI 加速器之间最核心的架构差异是什么?
NVIDIA 侧重于采用专有 NVLink 互连和低精度 Tensor Core 的纵向整合系统;AMD 则强调采用模块化小芯片(Chiplet)架构,并在单个加速器上配备超高容量的板载高带宽内存 (HBM)。
AMD ROCm 能否免修改直接运行 PyTorch 和 TensorFlow 模型?
可以。现代版本的 ROCm 已经实现了与 PyTorch 等主流深度学习框架的原生整合,标准 AI 模型只需极少甚至无需修改代码即可直接进行训练和推理。
为什么 NVIDIA 在企业级 AI 市场上能够维持更高的溢价?
NVIDIA 凭借其成熟的 CUDA 软件生态系统、经过充分验证的端到端网络解决方案,以及多年来建立的高开发者普及度拥有极高定价权,这大幅降低了企业的部署摩擦与技术迁移成本。
AMD 如何在数据中心总体拥有成本 (TCO) 上与 NVIDIA 竞争?
AMD 的竞争策略在于单加速器提供更大的显存容量,使得企业运行大语言模型时能够部署更少的物理节点,同时配合极具竞争力的硬件采购价格和更短的供货周期。